


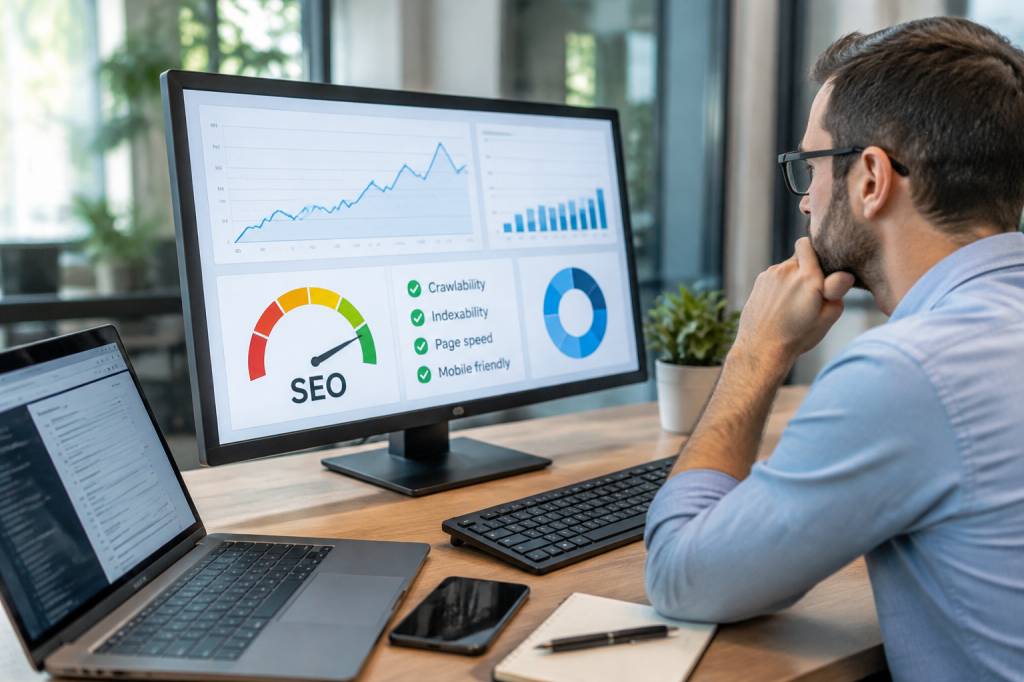
Un site peut publier des articles brillants, proposer une offre irrésistible et disposer d’un design soigné. Si les moteurs de recherche peinent à explorer ses pages ou si les visiteurs attendent plusieurs secondes avant de voir le contenu, tout ce travail risque de rester dans l’ombre. C’est là qu’intervient l’audit SEO technique : une inspection méthodique des fondations du site, avant de demander à Google d’admirer la façade.
Pas besoin de démonter chaque ligne de code pour commencer. Un audit efficace suit des étapes claires, repère les obstacles les plus coûteux et transforme les constats en actions concrètes. Voici comment procéder, sans se perdre dans les détails qui impressionnent mais ne changent rien.
Définir le périmètre avant de sortir la boîte à outils
Un audit technique n’est pas une chasse au défaut menée au hasard. Avant d’ouvrir vos outils, précisez ce que vous voulez examiner : tout le site, une catégorie, une boutique en ligne ou une migration récente. Fixez aussi un objectif. Cherchez-vous à résoudre une baisse de trafic, à améliorer l’indexation ou à préparer une refonte ?
Cette étape paraît évidente, mais elle évite de consacrer une journée à corriger des détails sur des pages qui ne comptent pas. Pour un commerce en ligne, les pages de produits, les catégories et les filtres peuvent être prioritaires. Pour un média, on regardera de près les archives, les articles récents et les pages qui reçoivent déjà du trafic.
Rassemblez ensuite les accès nécessaires : outil de suivi des performances Google, outil de mesure d’audience et, si possible, journaux du serveur. Ils permettent de comparer ce que le site déclare, ce que Google explore et ce que les internautes utilisent réellement. Trois points de vue, parfois trois histoires différentes.
Vérifier que les bonnes pages sont explorables
Les moteurs doivent pouvoir accéder aux pages importantes pour les analyser. Commencez par vérifier le fichier robots.txt, placé à la racine du site. Il donne des indications aux robots sur les zones à explorer ou à éviter. Une règle trop large peut bloquer une partie essentielle du site : une petite ligne mal placée, et le moteur reste devant la porte.
Consultez également les rapports d’indexation dans l’outil de suivi Google. Une page peut être connue du moteur sans être indexée. Les raisons varient : contenu jugé insuffisant, page dupliquée, erreur technique ou choix volontaire de ne pas l’afficher dans les résultats. Ne cherchez pas à faire indexer chaque URL : les pages de connexion, les résultats de recherche internes ou certaines variantes de produits n’ont souvent aucune raison d’y figurer.
Pour examiner le site en profondeur, un outil d’exploration spécialisé peut parcourir les liens comme le ferait un robot. Il met en évidence les pages introuvables, les redirections, les titres manquants et les liens cassés. Comparez toujours ses résultats avec les données de Google : une exploration simulée n’est pas une reproduction parfaite du comportement du moteur.
À contrôler en priorité :
- Les pages stratégiques ne sont pas bloquées par le fichier robots.txt.
- Les pages utiles peuvent être indexées et ne portent pas d’instruction contradictoire.
- Le plan de site XML ne contient que des adresses pertinentes et accessibles.
- Les pages importantes sont accessibles depuis des liens internes, pas seulement depuis le plan de site.
Détecter les erreurs et les redirections inutiles
Une erreur 404 signifie que la page demandée n’existe pas à l’adresse indiquée. Quelques pages introuvables ne déclenchent pas l’apocalypse, mais des liens cassés sur des pages importantes nuisent à la navigation et gaspillent les visites des robots. Repérez les erreurs, puis décidez au cas par cas : restaurer la page, rediriger vers son équivalent ou laisser l’erreur si la page n’a aucun remplaçant pertinent.
Les redirections méritent la même attention. Une redirection permanente est utile lorsqu’une adresse change durablement, notamment après une refonte. En revanche, une chaîne de redirections — une adresse qui envoie vers une deuxième, puis une troisième — ralentit le parcours et complique la compréhension du site. Mieux vaut diriger directement l’ancienne adresse vers la destination finale.
Imaginons une boutique qui modifie la structure de ses catégories. Si chaque ancienne adresse renvoie à une catégorie intermédiaire avant d’atteindre la nouvelle, les visiteurs perdent du temps et les robots aussi. Une liste des anciennes et nouvelles adresses, préparée avant la mise en ligne, évite bien des sueurs froides.
Maîtriser les adresses et les doublons
Un même contenu peut parfois être accessible par plusieurs adresses : avec ou sans barre oblique finale, en version sécurisée ou non, avec des paramètres de suivi ou dans plusieurs catégories. Pour un moteur, ces variantes peuvent ressembler à des pages distinctes, même si l’internaute y voit la même chose.
Choisissez une adresse de référence pour chaque page et utilisez des indications canoniques cohérentes. Cette balise signale quelle version doit être considérée comme principale. Elle ne remplace pas une architecture propre : si toutes les variantes pointent dans des directions différentes, l’indication devient aussi utile qu’un panneau routier qui change de sens selon la météo.
Sur un site marchand, les filtres peuvent générer des milliers d’adresses combinant couleur, taille, prix et ordre d’affichage. Certaines variantes répondent à une vraie demande et méritent une page dédiée. D’autres créent une multitude de pages sans valeur distincte. Analysez les données de recherche et le comportement des visiteurs avant de choisir lesquelles garder accessibles aux moteurs.
Examiner la vitesse et l’expérience sur téléphone
La vitesse compte pour les visiteurs comme pour les moteurs. Une page lente augmente les risques de départ, surtout sur téléphone et avec une connexion moyenne. Les indicateurs essentiels du Web évaluent notamment la rapidité d’affichage du contenu principal, la réactivité et la stabilité visuelle. Ils ne résument pas toute l’expérience, mais ils donnent des repères utiles.
Testez quelques modèles de pages représentatifs plutôt que la page d’accueil seule : article, catégorie, fiche produit et page de contact. Repérez les images trop lourdes, les scripts inutiles, les polices qui retardent l’affichage ou les éléments qui se déplacent pendant le chargement. Une grande image décorative peut sembler anodine à l’équipe de création ; sur un téléphone ancien, elle devient parfois le poids lourd du convoi.
Les améliorations les plus fréquentes sont simples : compresser les images, choisir des formats adaptés, charger les éléments hors écran au bon moment, réduire les extensions superflues et mettre en cache les ressources. Vérifiez aussi que les boutons et les menus sont faciles à utiliser sur un petit écran. Une page rapide mais impossible à parcourir reste une page frustrante.
Contrôler le contenu rendu et les données structurées
Certains sites construisent une partie importante de leur contenu avec JavaScript. Cela peut fonctionner, mais il faut s’assurer que le texte principal, les liens et les éléments utiles sont bien visibles après le rendu de la page. Si le moteur ne voit qu’un écran vide ou un menu sans destination, le problème n’est pas esthétique : il est technique.
Comparez l’affichage dans un navigateur avec la version rendue par les outils d’inspection disponibles. Portez une attention particulière aux pages qui dépendent d’une interaction pour afficher leur contenu. Les liens essentiels ne devraient pas exiger un clic complexe ou une action que les robots ne peuvent pas effectuer.
Les données structurées, quant à elles, aident les moteurs à interpréter certains éléments : produit, article, événement ou organisation, par exemple. Elles ne garantissent pas un affichage enrichi dans les résultats, et ce n’est pas une raison pour les abandonner. Assurez-vous simplement qu’elles décrivent fidèlement le contenu visible et ne comportent pas d’erreurs. Ajouter un avis qui n’existe pas sur la page est une mauvaise idée, même si l’étoile supplémentaire fait de l’œil.
Inspecter les liens internes et la profondeur des pages
Les liens internes aident les visiteurs à trouver leur chemin et les moteurs à comprendre les relations entre les pages. Une page importante enfouie à six clics de l’accueil risque de recevoir moins d’attention qu’une page reliée depuis plusieurs contenus pertinents. Examinez la profondeur des pages et repérez celles qui n’ont aucun lien entrant interne.
Les textes des liens doivent aussi être compréhensibles. « En savoir plus » peut convenir dans un contexte clair, mais une formulation descriptive indique mieux ce que l’on trouvera après le clic. Reliez les contenus complémentaires de manière naturelle : un article sur l’indexation peut mener vers un guide consacré au plan de site, sans transformer chaque paragraphe en carrefour autoroutier.
Sur les grands sites, les pages orphelines — accessibles uniquement par leur adresse directe ou par un plan de site — passent souvent sous le radar. Croisez les résultats de votre outil d’exploration avec les pages connues dans les données de mesure et celles qui reçoivent des visites. L’écart révèle parfois des contenus utiles oubliés dans l’architecture.
Prioriser les corrections plutôt que collectionner les alertes
Un audit peut produire des centaines de lignes. Le nombre d’alertes ne mesure pas la gravité des problèmes : un titre manquant sur une page secondaire n’a pas le même impact qu’un blocage empêchant Google d’accéder à toutes les catégories. Classez chaque problème selon trois critères : impact potentiel, nombre de pages concernées et effort de correction.
Une façon simple de travailler consiste à séparer les constats en trois groupes :
- À traiter en priorité : pages importantes bloquées, erreurs généralisées, mauvaise version du site indexée ou redirections défectueuses après une migration.
- À planifier : lenteurs récurrentes, pages orphelines, doublons et architecture interne difficile à parcourir.
- À surveiller : anomalies isolées sans effet notable sur les visiteurs ni sur l’accès aux pages utiles.
Documentez chaque action avec une adresse concernée, un responsable et un résultat attendu. Après correction, relancez les vérifications et observez l’évolution des données. Une intervention n’est pas réussie parce qu’une alerte a disparu dans un tableau ; elle l’est si les pages fonctionnent mieux et que les moteurs peuvent les traiter correctement.
Faire de l’audit un rendez-vous régulier
Un audit SEO technique n’est pas un rituel à pratiquer une fois, puis à ranger avec les anciennes sauvegardes. Le site évolue : nouvelles pages, changements de modèle, extensions mises à jour, refonte ou simple modification de navigation. Chaque intervention peut introduire un problème que personne n’avait prévu.
Prévoyez un contrôle régulier, ainsi qu’une vérification complète avant et après toute migration importante. Gardez une trace de l’état initial, des corrections et de leurs effets. Cette mémoire évite de répéter les mêmes erreurs et permet de distinguer une vraie amélioration d’une simple coïncidence.
La meilleure méthode reste pragmatique : repérer les obstacles qui empêchent l’accès aux pages utiles, corriger ce qui gêne réellement les visiteurs, puis vérifier les résultats. La technique ne remplace ni un contenu solide ni une stratégie éditoriale, mais elle leur ouvre la porte. Et dans les coulisses du référencement, une porte bien ouverte vaut parfois mieux qu’un nouveau tour de magie algorithmique.


